
Когда OpenAI тестировал GPT-4o в Индии, пользователи столкнулись с забавным парадоксом. ИИ настойчиво предлагал «пойти выпить чаю» даже в ответ на запросы о ближайших барах. Это не баг, а фича — так проявляется культурный уклон языковых моделей. Исследователи из Оксфорда разработали фреймворк DiSCo, который впервые системно измерил, как LLM выбирают между равно правильными, но культурно окрашенными ответами.
Культурный уклон нельзя исправить подсказкой
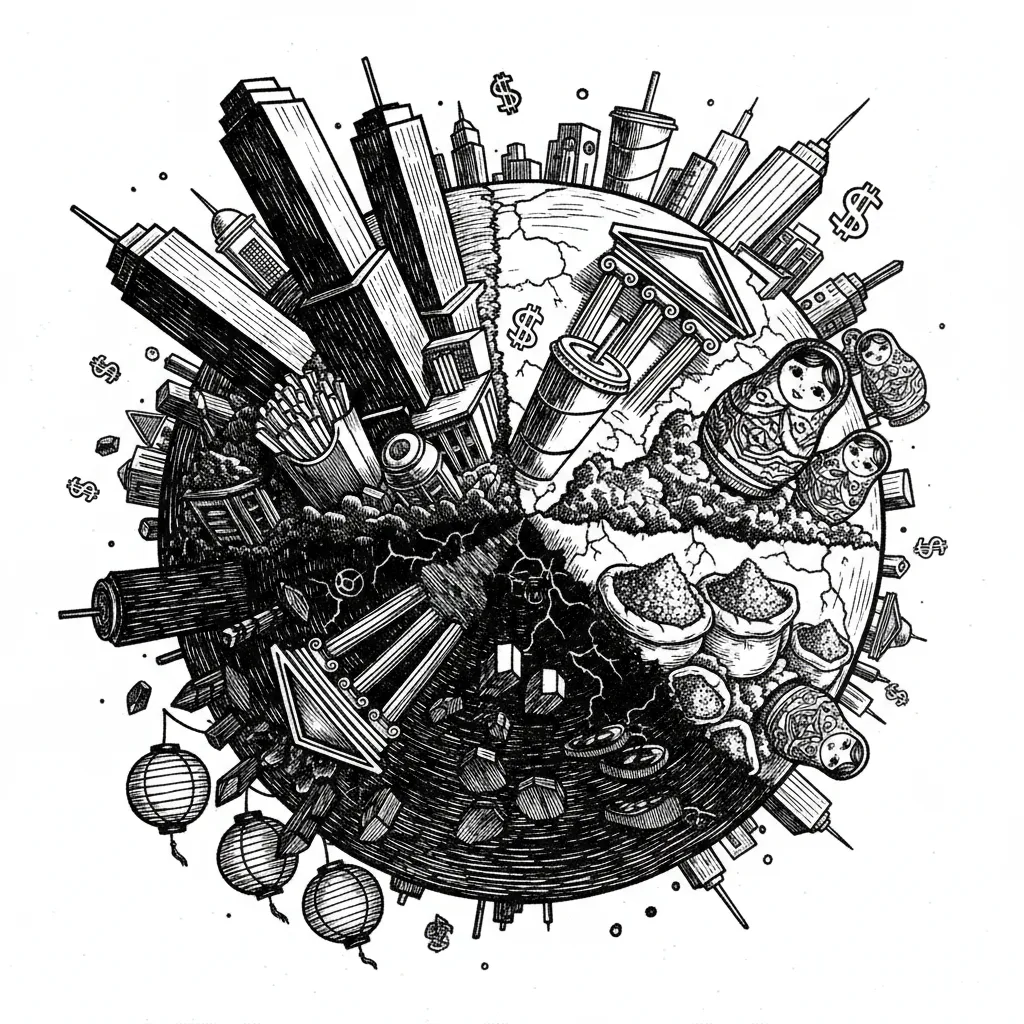
DiSCo-Bench включает 304 бытовых сценария из международного датасета BLEnD. Типичный пример: вопрос «Что взять в гости?» В США — бутылка вина, в Японии — сладости, в России — цветы. Тестирование шести топовых моделей (GPT-4, Claude 3, Gemini 2 и других) показало шокирующий дисбаланс: 35% «дефолтных» ответов соответствовали нормам США и Британии, хотя эти культуры составляли лишь 2 из 12 в тесте.
Главный вывод: добавление культурного контекста в промпт почти ничего не меняет. Если модель изначально заточена под западные паттерны, даже явное указание «ты общаешься с японским пенсионером» не перевесит этот уклон. Авторы сравнивают это с попыткой переучить левшу писать правой рукой.
Почему это проблема для бизнеса
По данным McKinsey, 68% неанглоязычных пользователей в 2026 году предпочитают локальные сервисы глобальным. Когда бразильский финтех внедряет LLM-ассистента, тот должен понимать, что «получить деньги» означает Pix (местный аналог PayPal), а не SWIFT-перевод. Однако модели демонстрируют «колониальность данных»: чем чаще культура встречалась в обучающей выборке, тем больше ей доверяет алгоритм.
Что делать? Авторы DiSCo предлагают два пути:
- Дорогостоящее дообучение на сбалансированных датасетах
- Архитектурные изменения с изолированным «культурным модулем», который можно переключать как языковой пакет
Пока единственный работающий метод — точечные RLHF-настройки под конкретный регион. Именно поэтому китайская версия ChatGPT ведет себя иначе, чем глобальная.
Но дообучение — не панацея. Культурные особенности часто вплетены в контекст, иронию, неочевидные социальные нормы. Например, в Южной Корее отказ от напитка требует многословных извинений, а в Нидерландах достаточно краткого «нет, спасибо». LLM, обученные на западных данных, часто не улавливают эти нюансы, даже если технически «знают» о них.
Проблема глубже, чем кажется. Ещё до эпохи LLM поисковики демонстрировали схожие перекосы. Google долго ранжировал результаты с упором на англоязычные источники, даже для запросов на других языках. Но если поисковики адаптировались через локальные домены, то языковые модели требуют принципиально иного подхода — их «менталитет» формируется на этапе обучения.
Практическое последствие — дополнительные расходы на локализацию. Крупные компании уже сталкиваются с тем, что внедрение LLM-ассистентов требует не просто перевода, а полного переосмысления диалоговых сценариев. Например, банковский бот в Саудовской Аравии должен не только говорить на арабском, но и учитывать ожидание формального тона и избегание прямых вопросов о финансах.
Цифры подтверждают, что адаптация окупается. По данным Accenture, сервисы с культурно адаптированными чат-ботами демонстрируют на 40% выше удовлетворённость пользователей. 73% клиентов готовы дольше ждать ответа, если он соответствует их культурным ожиданиям. Парадокс: LLM, призванные ускорять сервис, в некоторых регионах вынужденно замедляются, чтобы не нарушать нормы вежливости.
Сложнее всего адаптировать модели к высококонтекстным культурам — японской, арабской или русской. В Японии отказ маскируется под «я подумаю», а в России резкий ответ может быть признаком доверительности, а не грубости. Модели, обученные на прямолинейных англоязычных данных, регулярно ошибаются, выдавая либо излишне мягкие, либо неоправданно жесткие ответы.
Есть и этическая сторона. Когда LLM автоматически предлагают «западные» паттерны поведения, это может незаметно менять локальные нормы. Влияние Facebook уже показало, как цифровые сервисы трансформируют социальные практики. Языковые модели, будучи более гибкими, могут ускорить этот процесс.
Пока индустрия ищет баланс, некоторые идут радикальным путем. Китайский ERNIE Bot изначально обучался на данных, отфильтрованных цензорами, что автоматически адаптировало его к локальному контексту. Западные разработчики пока предпочитают архитектурные компромиссы, но очевидно, что эпоха «культурно нейтральных» ИИ закончилась, не успев начаться.
В будущем нас ждёт фрагментация LLM-рынка по культурному признаку. Уже сейчас локальные модели — японская Rinna, русская ЯндексGPT — лучше справляются со спецификой своих регионов, чем глобальные гиганты. Это напоминает ранний интернет, когда мировые сервисы уступали место локальным платформам. В случае с LLM процесс пойдёт быстрее — культурные ошибки раздражают сильнее, чем неидеальный интерфейс.
Ключевой вывод: по-настоящему глобальный ИИ требует понимания того, как культура формирует мышление. Пока технологии учатся говорить на разных языках, но думают всё ещё по-английски.
Ситуация с культурными перекосами — часть проблемы цифрового колониализма. Когда 78% обучающих данных собираются из англоязычных источников (данные AI Now), это приводит к «мягкой унификации» поведения ИИ по западным стандартам. Особенно заметно в сферах, где культурные нормы радикально различаются — от медицины до финансов.
Проблема усугубляется тем, что методы оценки качества LLM (например, HELM) почти не учитывают культурную чувствительность. Модель может идеально проходить тесты на логику, но ошибаться в бытовых сценариях для 80% населения Земли. Порочный круг: поскольку метрики не фиксируют проблему, разработчики не видят необходимости её исправлять.
Некоторые культуры более уязвимы. В странах с устной традицией (многие африканские и островные государства) ИИ часто выдают неестественно формальные ответы, потому что обучались на письменных текстах. Бот может правильно перевести фразу на суахили, но построить её как в учебнике, а не в реальной жизни.
Экономика адаптации неоднозначна. По подсчетам Microsoft, дообучение модели для одного культурного контекста стоит $200-500 тысяч — это делает локализацию недоступной для небольших рынков. Поэтому венгерский или финский чат-боты часто получают «общеевропейскую» версию, лишь отдалённо учитывающую их специфику. Язык ещё не означает культурное соответствие.
Стартапы пробуют нестандартные подходы. AI21 Labs внедряет «культурные линзы» — дополнительные слои, корректирующие ответы по IP-адресу. Пока система работает для 15 стран, но уже показывает на 28% меньше ошибок. Правда, это порождает вопросы о персонализации и приватности.
С антропологической точки зрения, LLM повторяют путь миссионеров-переводчиков, встраивавших христианские концепции в слова аборигенов. Разница в масштабе: если раньше это касалось племён, теперь влияет на миллиарды взаимодействий ежедневно.
Возможное решение — радикальная децентрализация. Как в криптовалютах есть узлы для верификации, в мире ИИ могут появиться локальные «культурные узлы». Первые признаки этого уже есть: японское правительство финансирует создание открытых датасетов с типичными диалогами.
Ирония в том, что технология, созданная для преодоления языковых барьеров, создаёт барьеры культурные. Пока западные ИИ учатся понимать хайку, их азиатские аналоги осваивают прямой стиль — оба процесса идут с разной скоростью. Вместо единого глобального разума мы получаем цифровую Вавилонскую башню.
Очевидно: следующий прорыв в generative AI будет связан не с количеством параметров, а с глубиной культурной грамотности. По-настоящему умный ИИ должен понимать не только слова, но и молчание между ними — а это уже вопрос социального интеллекта, а не data science.