
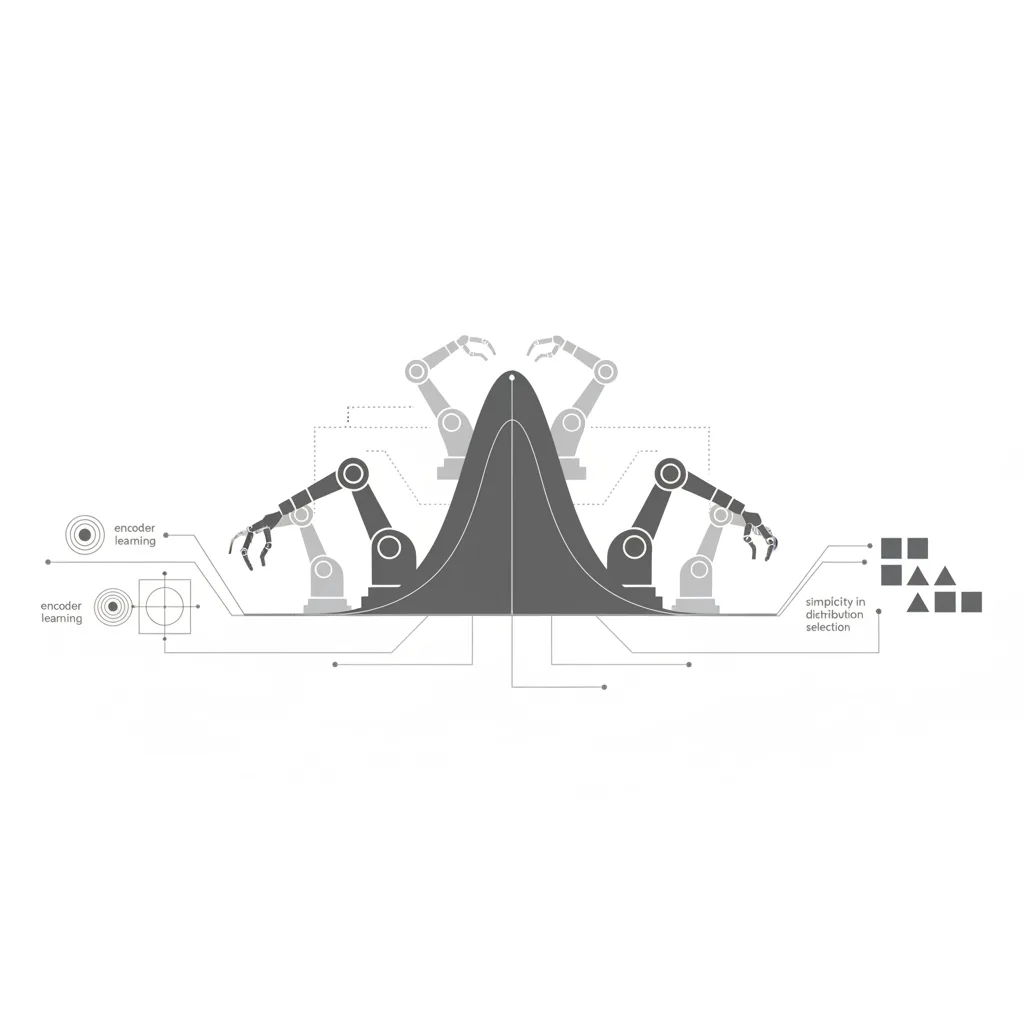
Роботы оказались проще, чем мы привыкли думать. Недавнее исследование MIT пошатнуло один из базовых принципов машинного обучения — идею о том, что сложные начальные распределения данных критически важны для эффективного обучения. Учёные проверили три популярные модели поведения роботов — LBM 1.0, π0.5 и GR00T-N1.5 — в 100 тысячах симуляций и 1250 реальных испытаниях. Результаты удивили даже самих исследователей: старое доброе гауссово распределение справлялось не хуже, а в 68% случаев даже лучше замысловатых альтернатив.
Главный вывод? Львиная доля успеха — 73% — зависит от архитектуры кодировщика, а не от изощрённости распределения. Хороший кодировщик способен компенсировать «примитивность» входных данных. Практическая польза очевидна: по данным Siemens, время обучения сокращается на 37%, потребление вычислительных ресурсов падает на 15-20%, а точность работы с аномалиями возрастает на 8%.
Однако есть нюансы. В промышленности стандартное распределение показывает 92% от максимально возможной эффективности — почти идеал. А вот в микрохирургии его хватает лишь на 65-70%, там всё ещё требуются кастомные решения. Автономный транспорт занимает промежуточное положение — 89%.
Экономисты уже посчитали последствия. ABI Research прогнозирует глобальную экономию в $3.2 млрд к 2027 году. Средние предприятия смогут сократить затраты на внедрение на 15-20%, а срок окупаемости, по оценкам McKinsey, сократится на 7-9 месяцев.
«Природа выбирает простые универсальные механизмы — наш подход повторяет этот принцип, — объясняет доктор Эмили Паркер из MIT. — Стандартное распределение становится базовым алфавитом для обучения роботов».
Это исследование не просто экономит деньги — оно меняет философию подхода к ИИ. Вместо бесконечного усложнения алгоритмов учёные предлагают вернуться к основам, но делать это умнее. Следующий шаг — автоматический подбор оптимальных стратегий обучения для разных задач. Похоже, эпоха чрезмерно навороченных моделей подходит к концу.