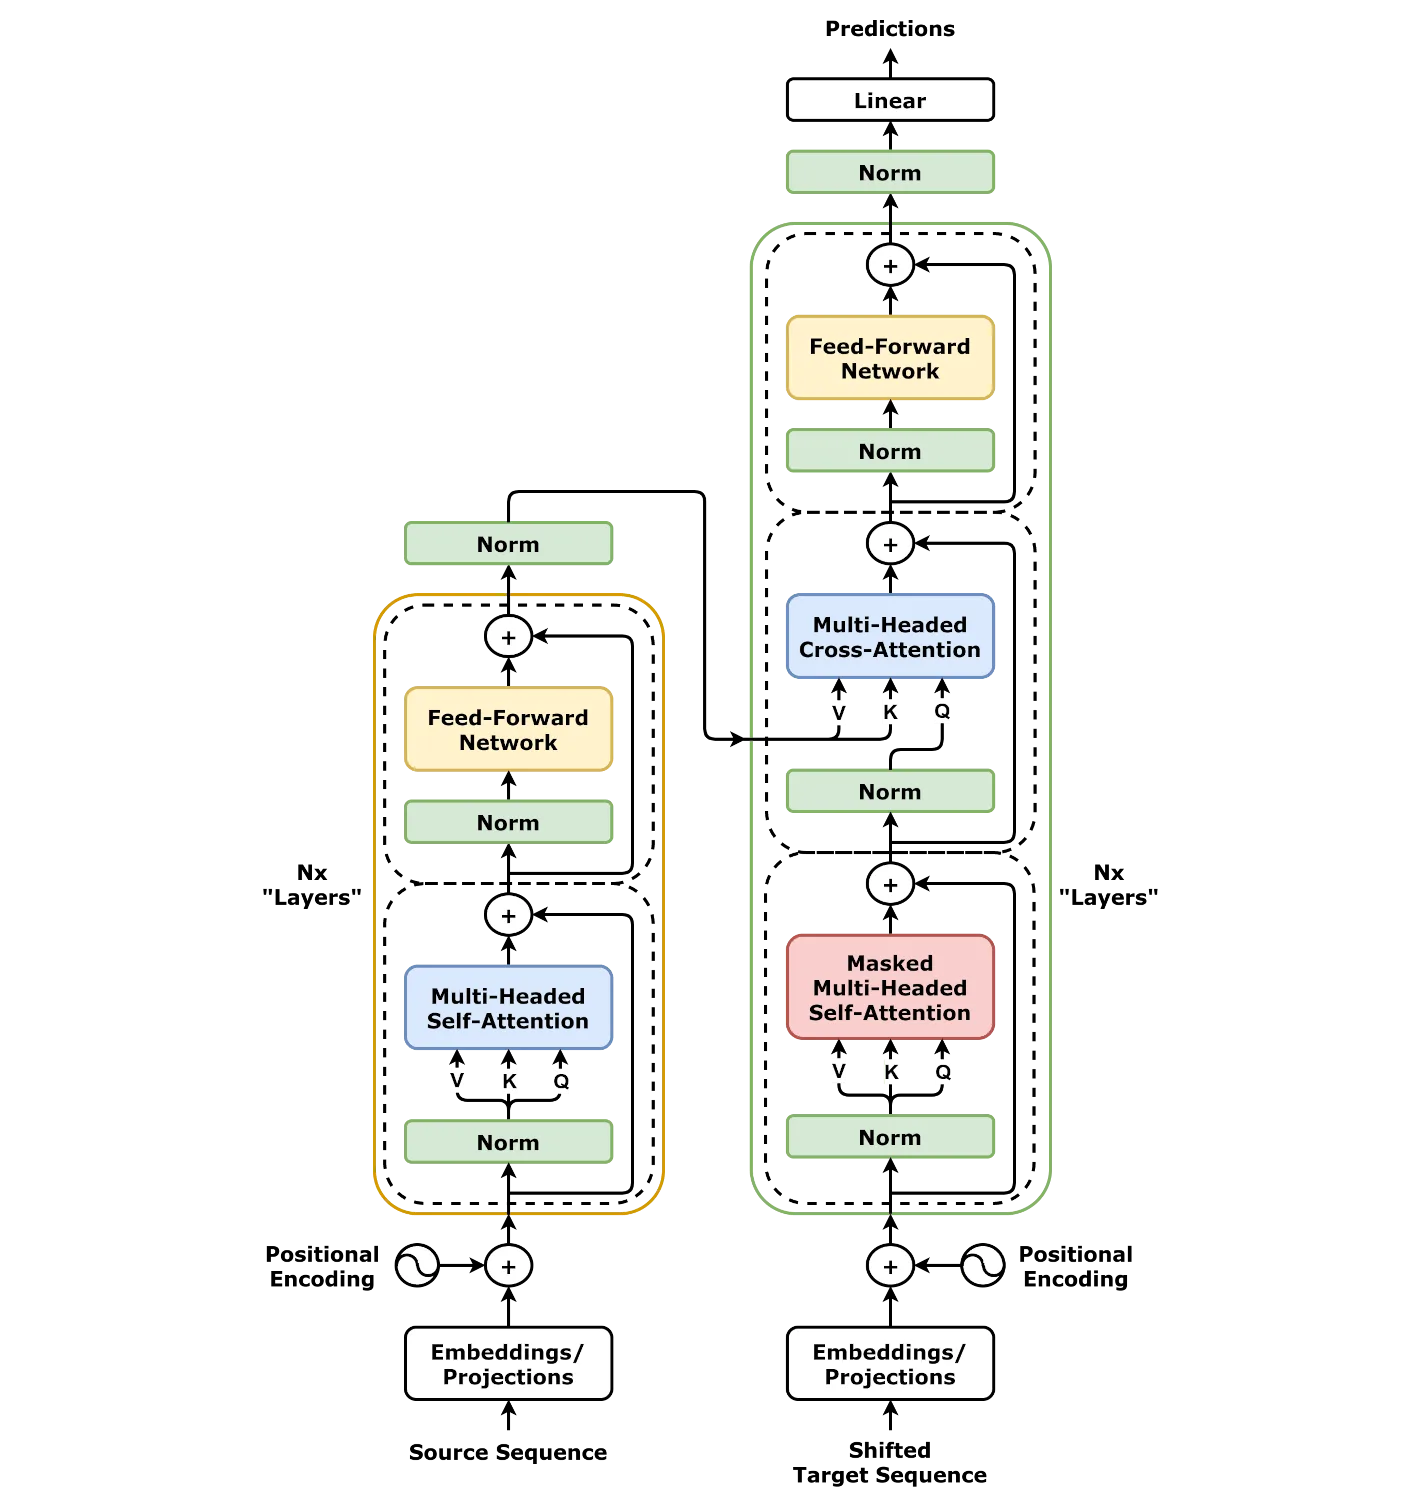
Многоголовое внимание — это ключевой компонент архитектуры трансформеров, который позволяет модели обрабатывать информацию параллельно через несколько независимых «голов». Каждая голова учится выделять разные типы зависимостей в данных. Например, одна может фокусироваться на синтаксисе, другая — на семантике.
Работает это так: входные данные проецируются в несколько подпространств (обычно 8 или 16), где каждая голова вычисляет свои веса внимания. Затем результаты объединяются. Такой подход улучшает способность модели улавливать сложные паттерны, которые одна голова могла бы пропустить.
В моделях типа GPT-3 (2020) и BERT (2018) многоголовое внимание помогает анализировать контекст на разных уровнях абстракции. Это критически важно для задач машинного перевода, где нужно учитывать и грамматику, и смысл предложения. Размерность голов обычно варьируется от 64 до 1024, в зависимости от масштаба модели.
Главное отличие от обычного механизма внимания — параллельная обработка. Одноголовое внимание похоже на просмотр изображения через узкую трубку, а многоголовое — на одновременный осмотр через несколько увеличительных стекол с разным увеличением. Это не просто увеличение параметров, а качественный скачок в способности модели к обобщению.