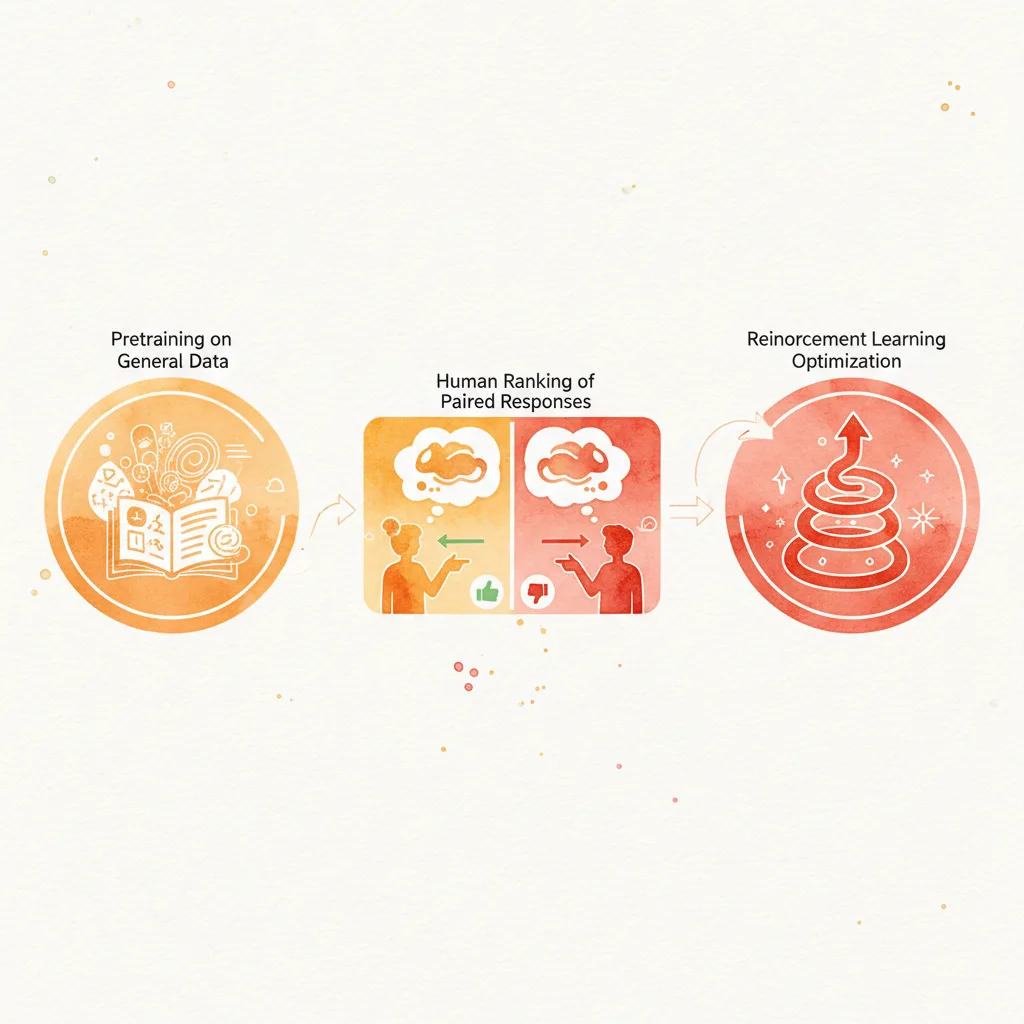
RLHF позволяет адаптировать большие языковые модели под нужды пользователей без переписывания их архитектуры. Человеческие оценщики ранжируют разные варианты ответов модели, а алгоритм обучения с подкреплением (RL) оптимизирует её поведение, чтобы чаще выдавать высокооценённые варианты.
Процесс включает три этапа: предобучение модели на общих данных, сбор человеческих оценок для пар ответов и тонкую настройку с помощью RL. Например, OpenAI использовала RLHF для ChatGPT, чтобы снизить количество вредных или бессмысленных ответов. В Anthropic подобный подход применили к Claude, добившись более корректного тона общения.
Без RLHF модели часто выдают технически правильные, но бесполезные на практике ответы. Однако у метода есть недостатки: зависимость от качества разметки, высокая стоимость сбора данных и риск чрезмерной оптимизации под узкий набор критериев.